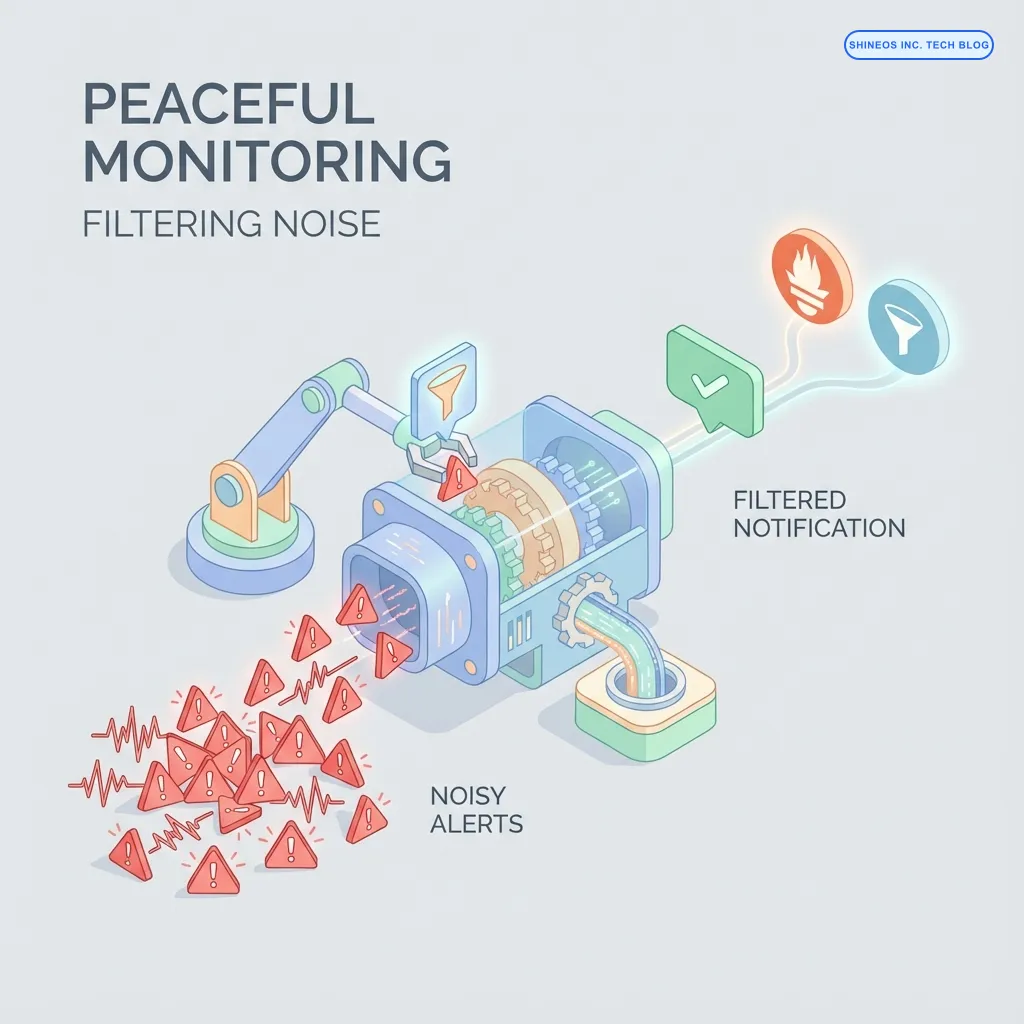
監視・オブザーバビリティ SRE
Prometheus運用で「アラートオオカミ少年」にならないための、Shineos流実践的Alertmanager設定術
Prometheus導入後に陥りがちな「アラート通知多すぎ問題」を解決します。AlertmanagerのGrouping、Inhibition、Silencing機能を活用し、本当に必要な通知だけを受け取る実践的な運用設定を解説します。
| 16 min read
Shineos Dev Team クラウドインフラ、CI/CD、監視・オブザーバビリティ、IaCなど、プロダクトの信頼性と運用効率を支えるSREの実践知見。
5 件の記事
Prometheus導入後に陥りがちな「アラート通知多すぎ問題」を解決します。AlertmanagerのGrouping、Inhibition、Silencing機能を活用し、本当に必要な通知だけを受け取る実践的な運用設定を解説します。
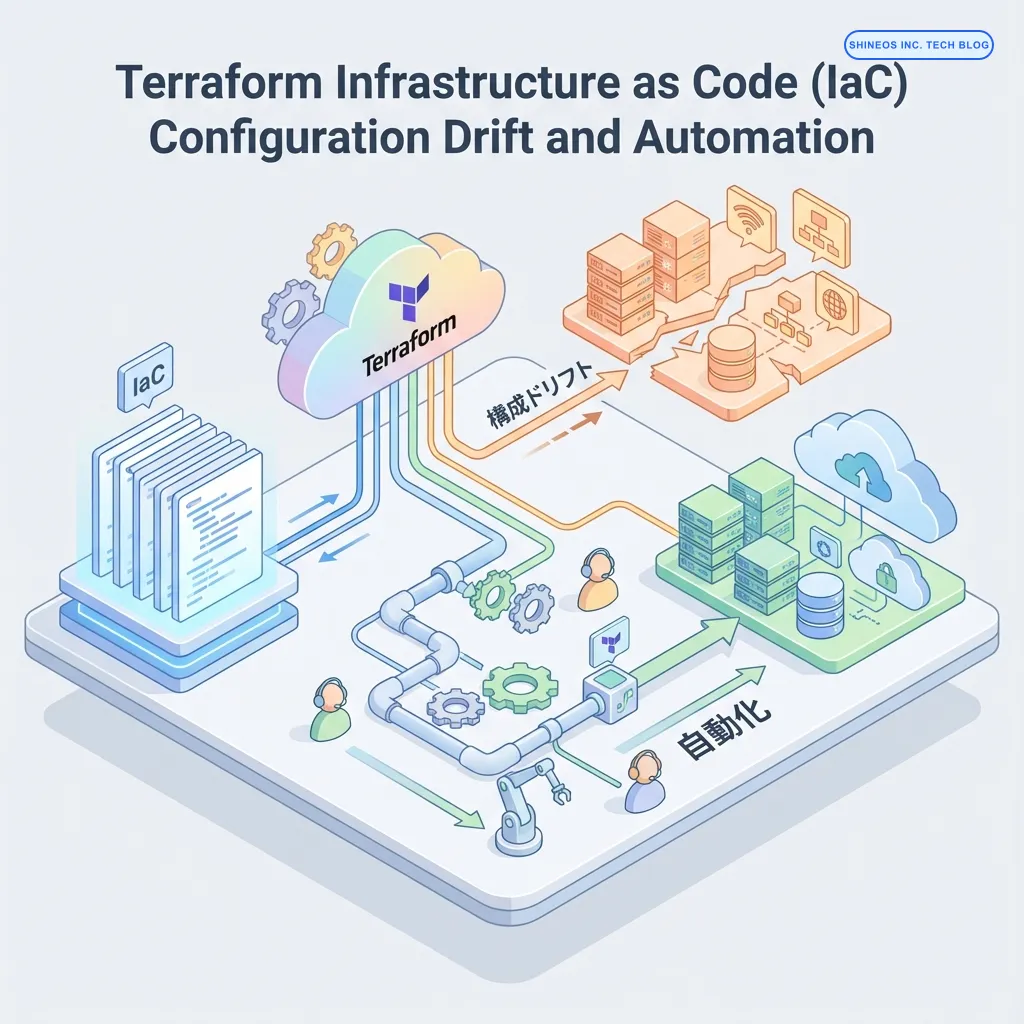
構成ドリフトは、実環境がコードとずれた状態です。検知は自動化し、修正はプルリクエストで人が確認します。コンソールからの直接変更を残さないのが要点です。適用はマージ後に行い、計画はプルリクエストで見ます。判断に必要な手順は本文にまとめています。
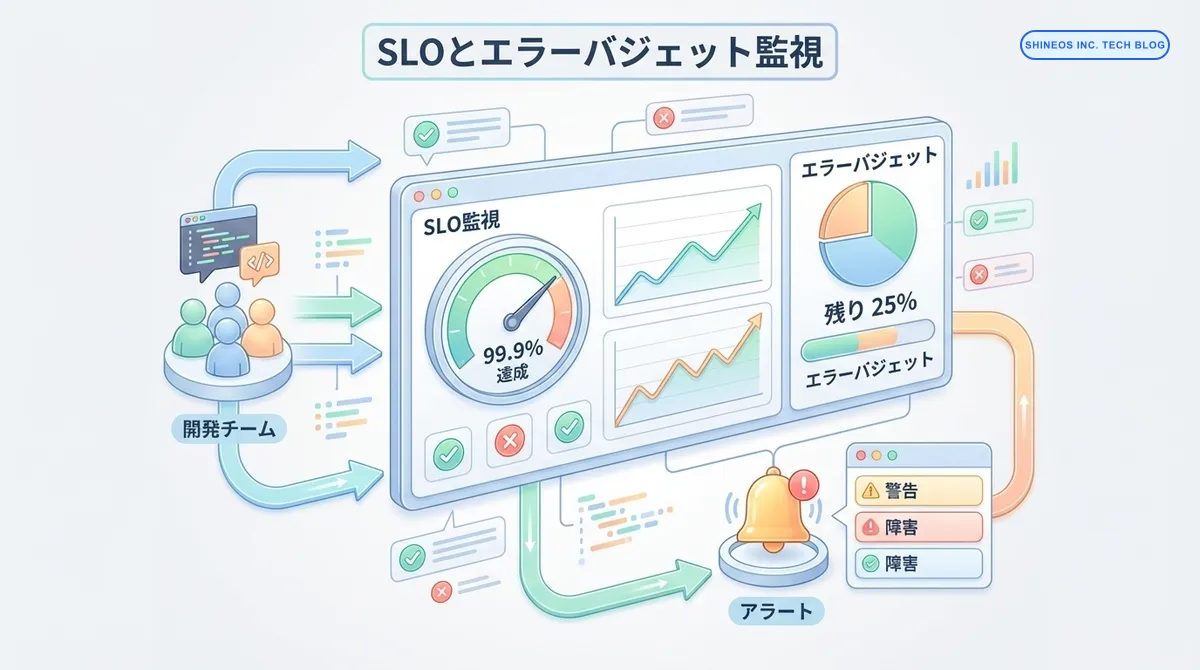
SLOは専任のSREがいなくても、実測から可用性の目標を一つ置いて始められます。使い切った予算は失敗ではなく、機能追加を止めて直す合図です。目標は実測の少し上から一つだけ置いて始めます。判断に必要な手順は本文にまとめています。
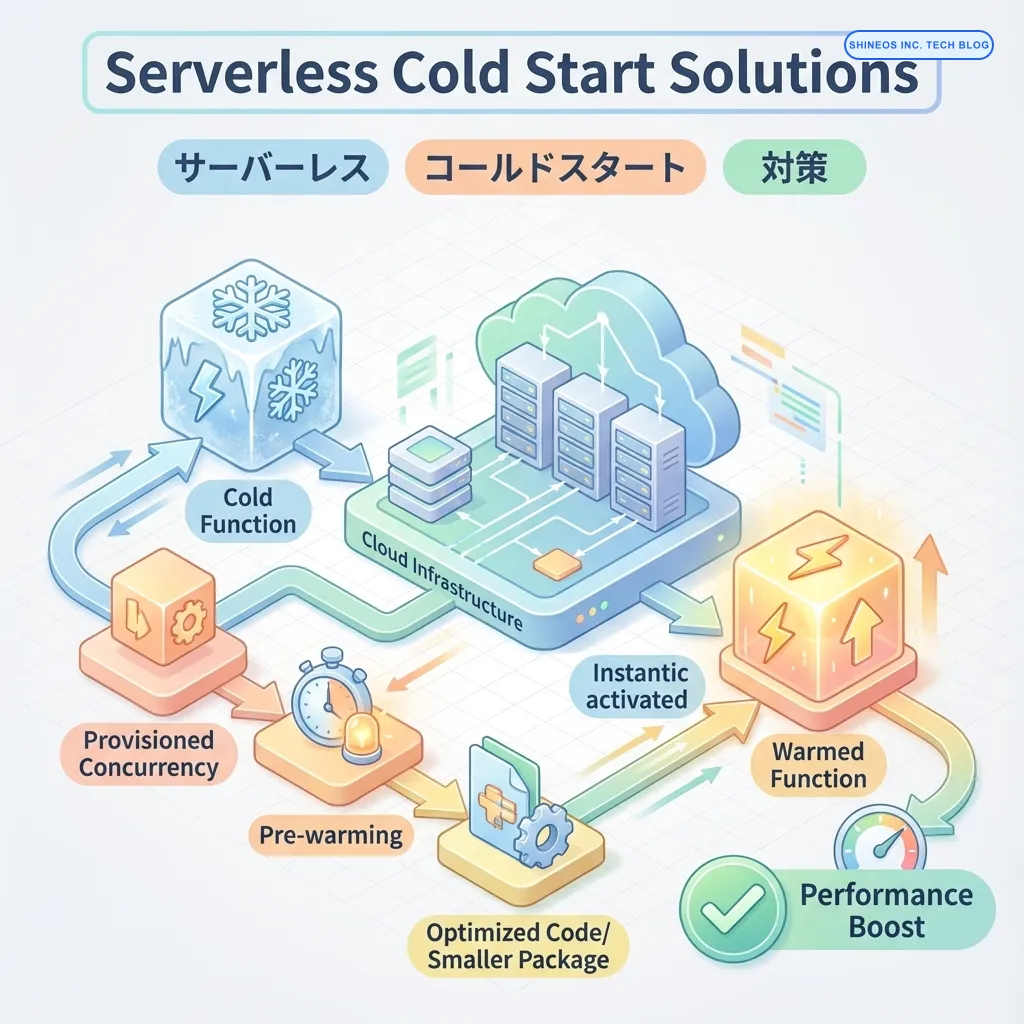
サーバーレスアーキテクチャの最大の課題「コールドスタート」。AWS LambdaやVercelでの実測データを基に、具体的な改善策とShineos流の実装パターンを徹底解説します。待たせると離脱する操作から、起動待ちを外します。
エッジはユーザーに近い場所で応答し、待ち時間を短くします。VercelとCloudflare Pagesは得意な処理が違うので、制限を見て載せる処理を決めます。重い業務処理は原点のサーバーに残します。判断に必要な手順は本文にまとめています。