Claude MCP AI
Claude CodeとMCP Serverによる次世代AIエージェント開発ガイド
Claude CodeとMCP Serverを活用し、AIエージェントと既存システムを安全かつ効率的に連携させる技術アーキテクチャと実装手法を徹底解説します。TypeScriptとPythonによる実践的な実装例も提示。
| 51 min read
Shineos Dev Team AIエージェント、RAG、プロンプトエンジニアリング、トークン最適化など、LLMをプロダクトに組み込むための実践的な設計知見と実装ガイド。
13 件の記事
Claude CodeとMCP Serverを活用し、AIエージェントと既存システムを安全かつ効率的に連携させる技術アーキテクチャと実装手法を徹底解説します。TypeScriptとPythonによる実践的な実装例も提示。
AIエージェントは、ツール呼び出しと状態を持たせて、会話の外の作業まで進める仕組みです。顧客対応では、呼べるツールと入力チェックを先に制限します。会話の生成と、ツールを選ぶループは別の仕組みです。判断に必要な手順は本文にまとめています。
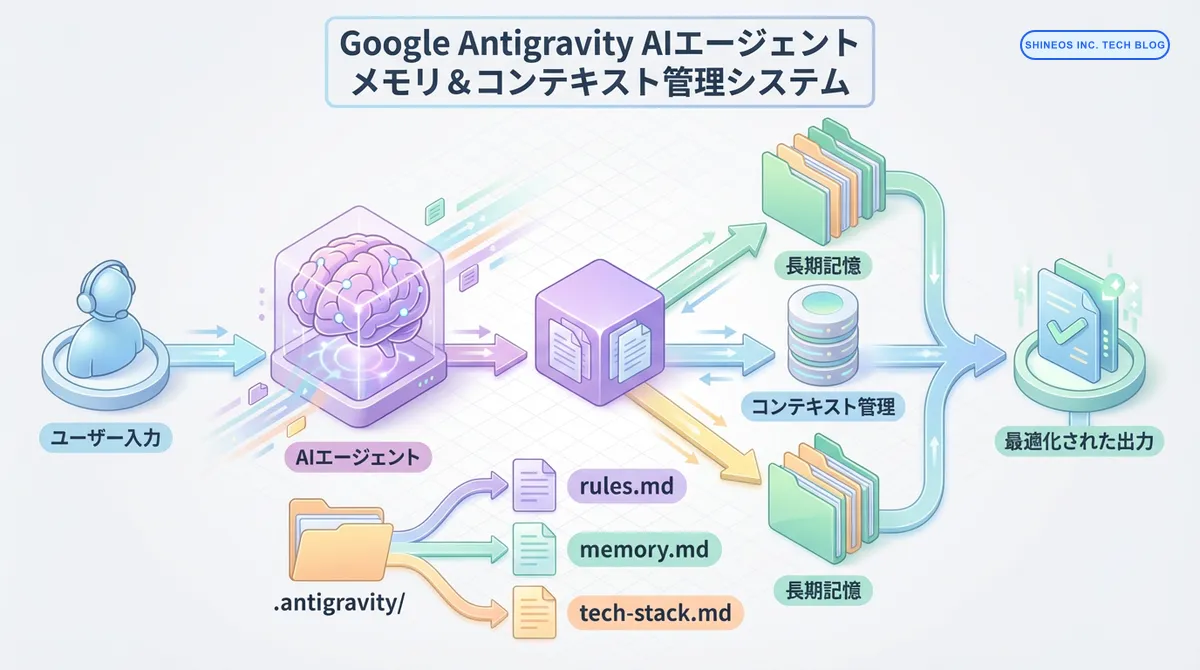
Zennで公開中の実践ガイドの続編。Google Antigravityの「エージェントメモリ」と「コンテキスト管理」を深掘りし、大規模プロジェクトでの実践的な設定テクニックを解説します。繰り返し頼む手順は、カスタムコマンドとして残します。
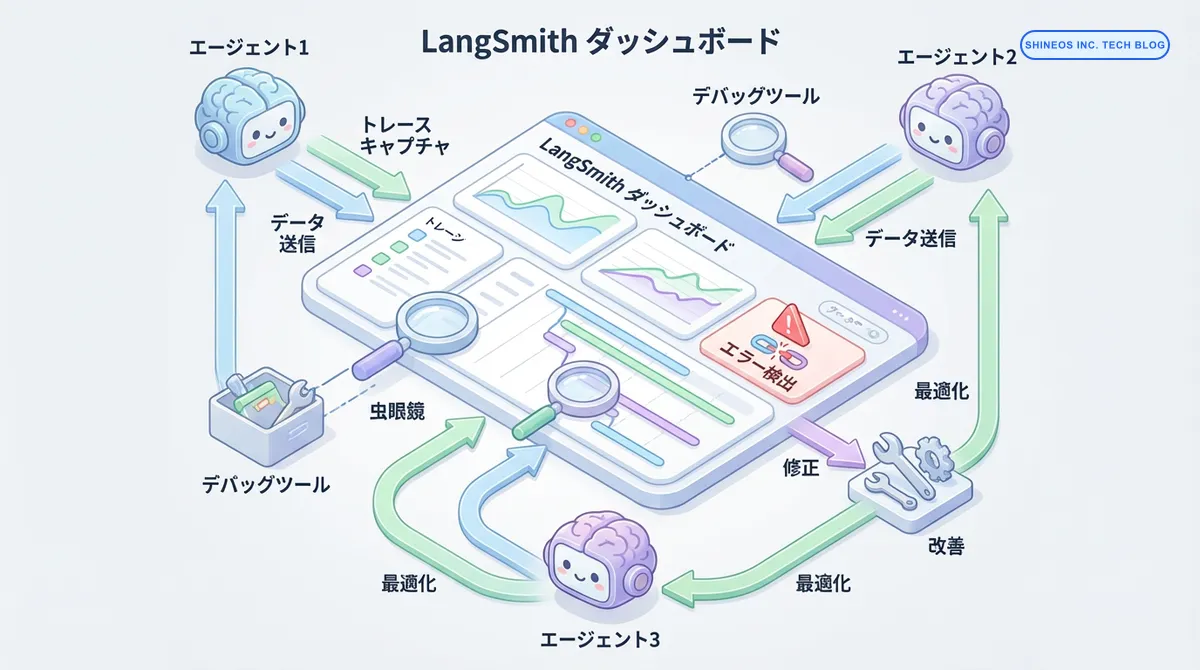
LangSmithはエージェントの呼び出しをトレースし、失敗、費用、遅延を本番でも追えるようにします。プロンプトの版と評価データを残すのが運用の要点です。本番では費用と遅延を、開発中の一件調査と分けて見ます。判断に必要な手順は本文にまとめています。
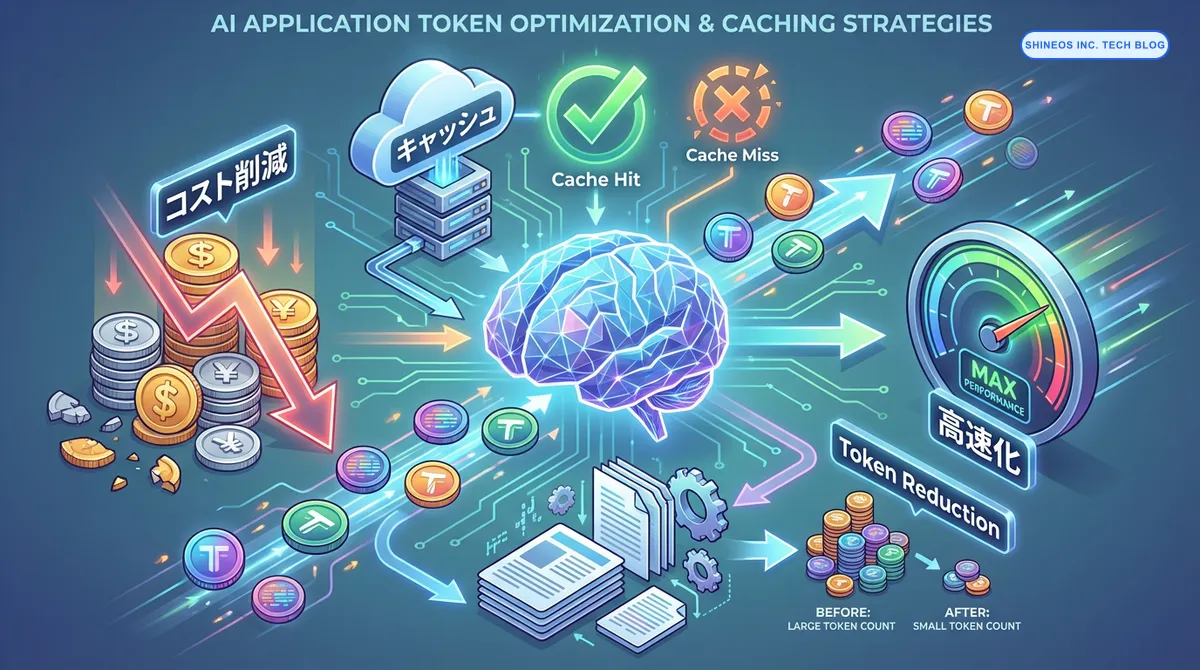
LLM APIのコストが予算を圧迫していませんか?トークン最適化とキャッシュで、使用量と応答速度を同時に改善する考え方と実装パターンを解説します。効果の幅はユースケースで変わります。短くすると精度が落ち、キャッシュすると最新性が落ちます。
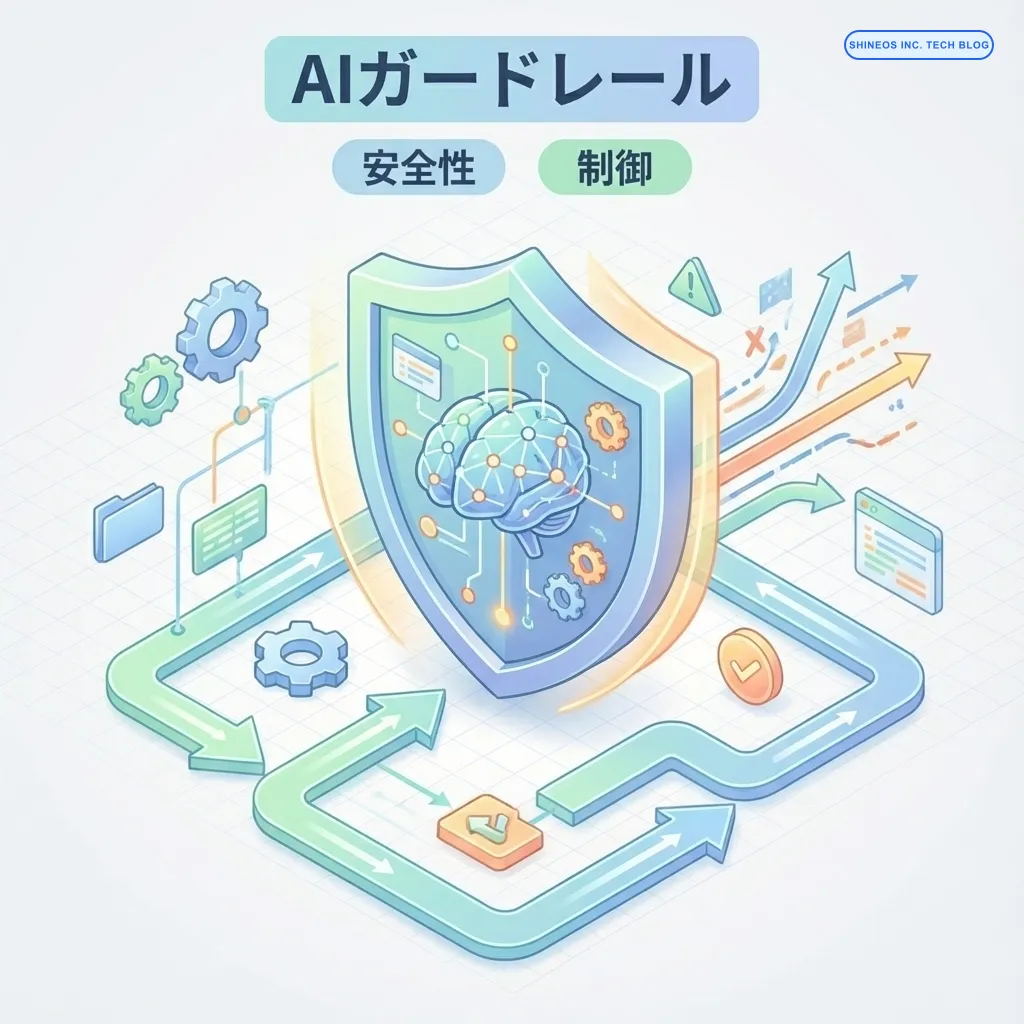
LLMの幻覚や不適切な回答を防ぐ「ガードレール」の実装パターンを解説。NVIDIA NeMo GuardrailsやShineos独自のバリデーションロジックを用いた、本番運用に耐えうるAIアプリケーション構築ガイド。
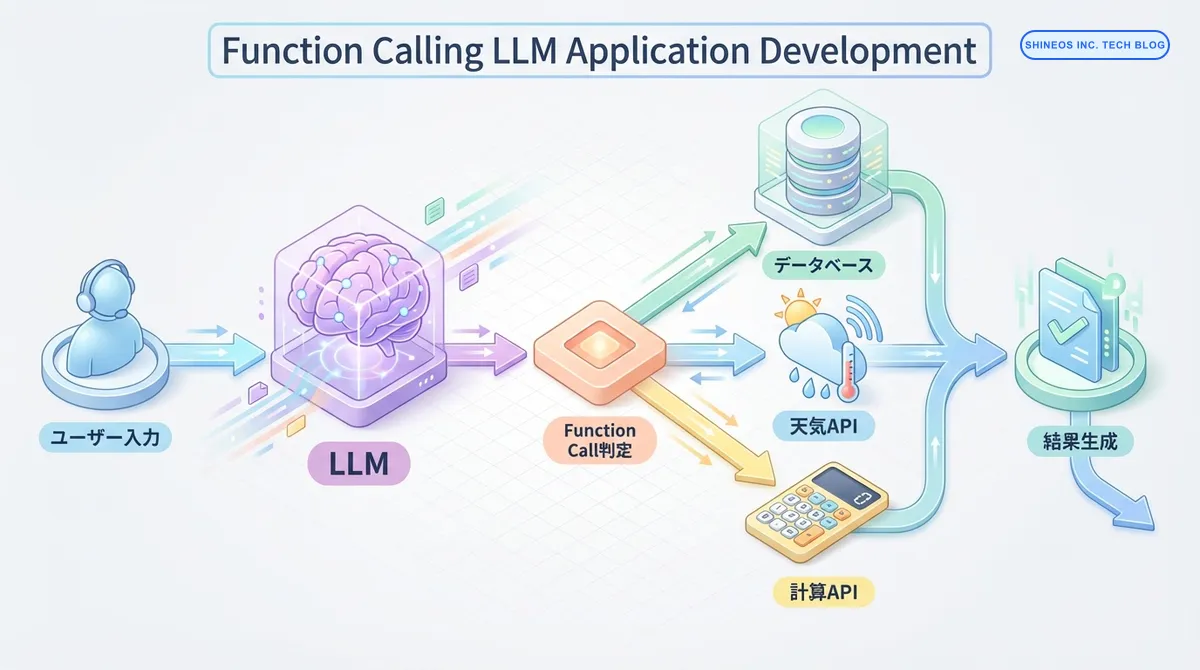
Function CallingはLLMに関数を選ばせ、引数で外部APIを呼びます。単発、複数からの選択、連鎖の3パターンと、失敗時の扱いを分けて設計します。呼べる関数は、業務ごとに限定して公開します。判断に必要な手順は本文にまとめています。
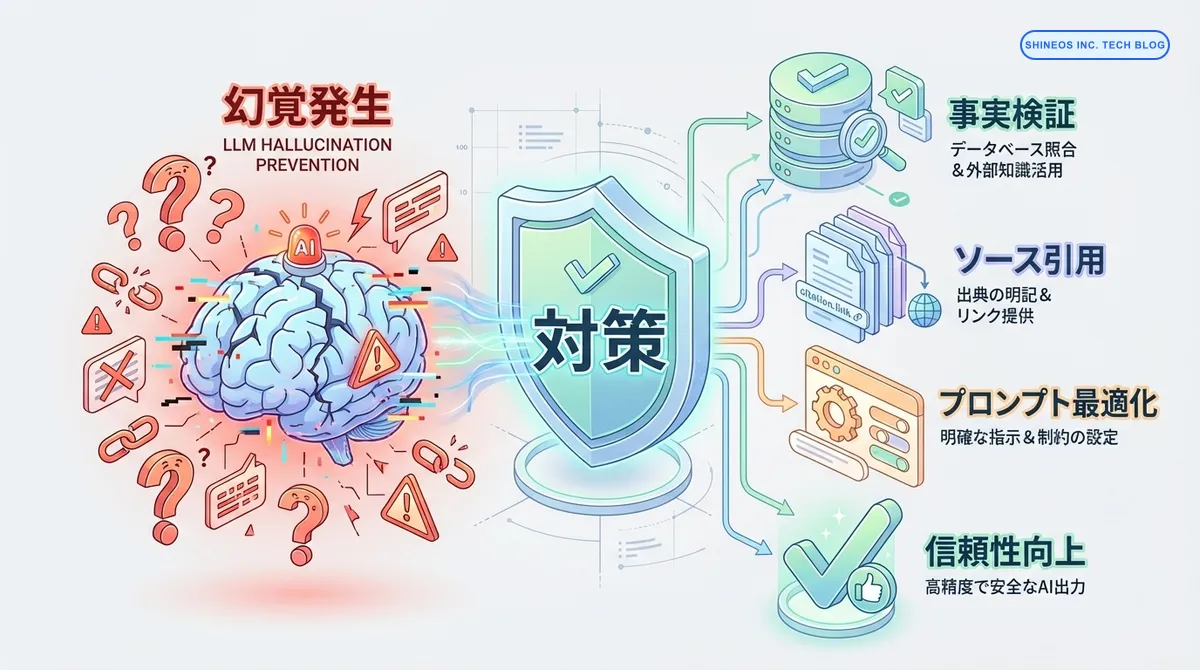
幻覚はRAG、プロンプト、出力検証、出典表示、生成パラメータを重ねて抑えます。重要な判断は自動判定だけで通さず、人が確認できる余地を残します。検査で落ちた回答は、利用者へ出さず検索の改善に回します。判断に必要な手順は本文にまとめています。
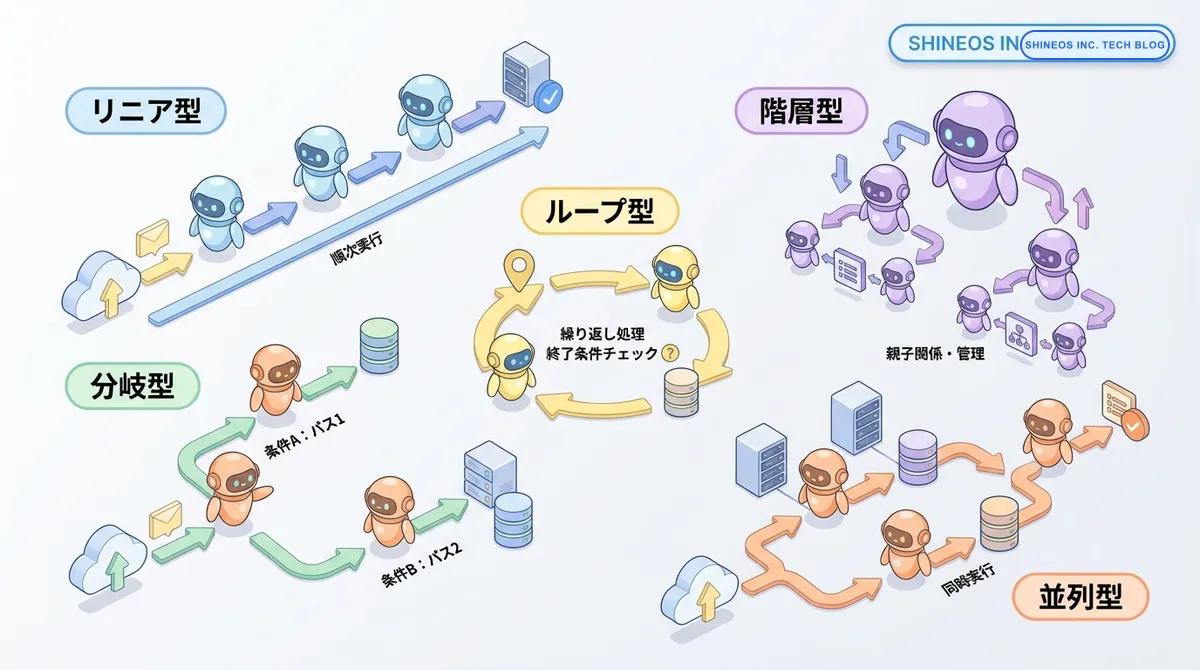
エージェントの流れは直線、分岐、反復、並列、階層から業務に合う型を選びます。最初は直線か分岐で始め、失敗時の扱いと費用の上限を先に置きます。手順が決まっている業務から、単純な型で始めます。判断に必要な手順は本文にまとめています。
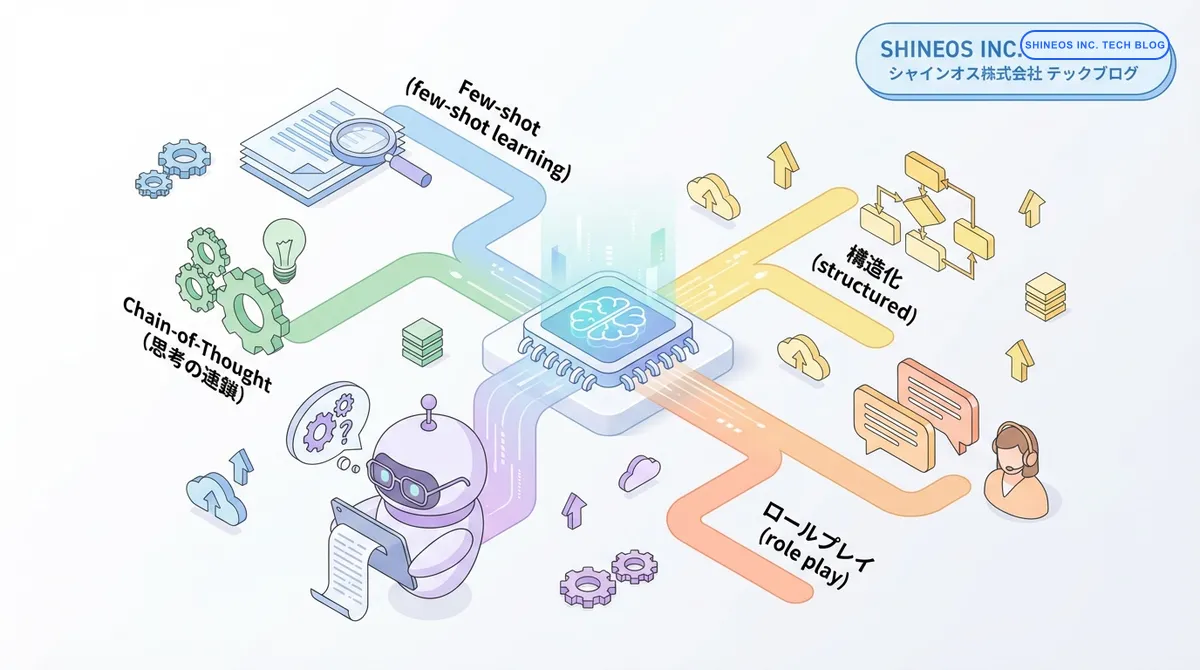
プロンプトは指示、文脈、出力形式を明示し、例示や思考の連鎖で精度を上げます。一度書いて終わらせず、版を残して比較しながら直すのが要点です。長い文脈は、費用と一緒に削る対象です。判断に必要な手順は本文にまとめています。
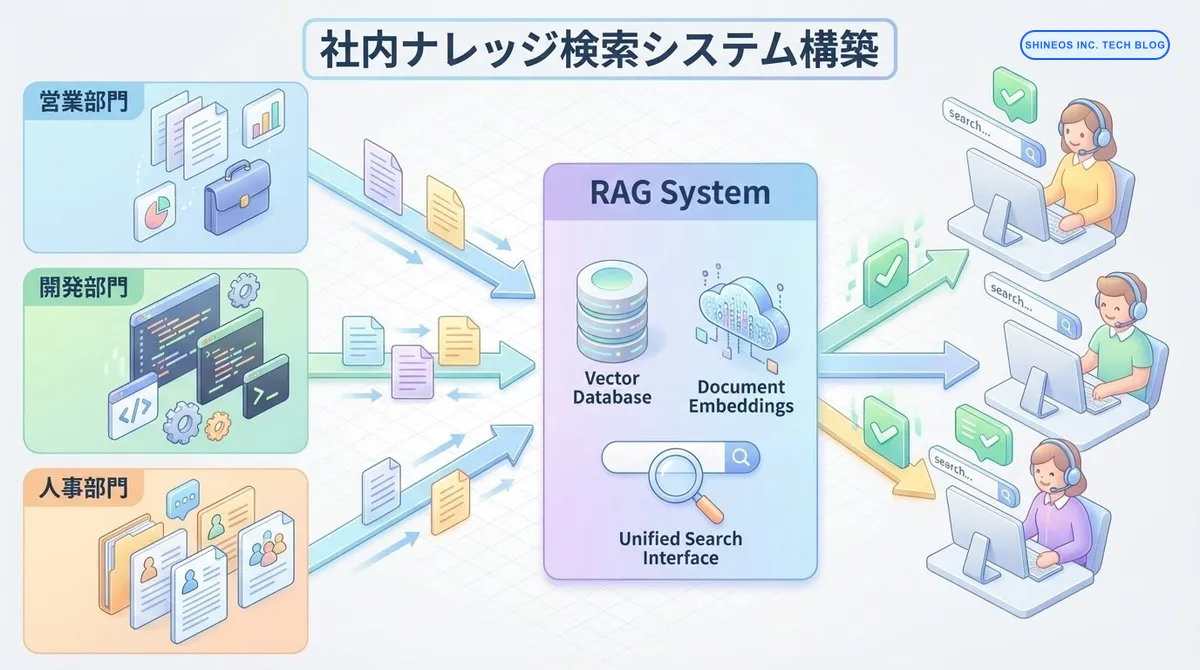
社内の散在した文書をRAGで検索し、小さくPoCしてからデータ源と精度を広げます。最初から全社展開せず、権限とコストを見ながら改善するのが要点です。見える文書は権限で絞り、外れは検索へ戻します。判断に必要な手順は本文にまとめています。
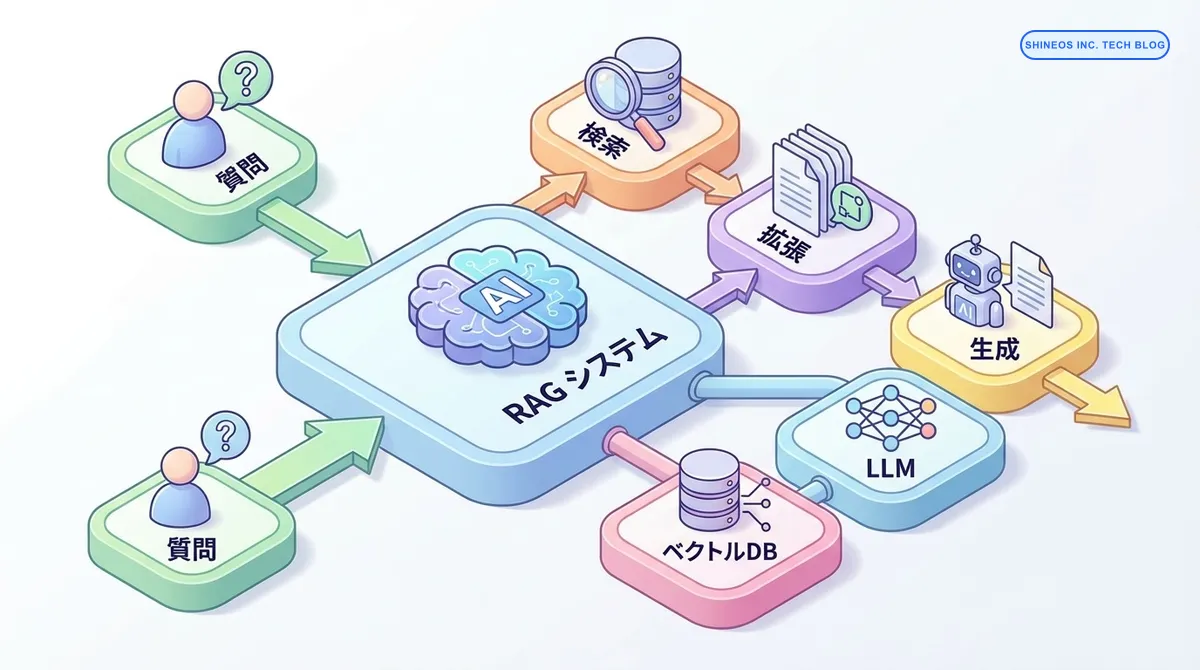
RAGは質問のベクトル検索で関連文書を渡し、LLMに回答させます。チャンク、ハイブリッド検索、再ランキングを用途に合わせて組み合わせるのが実装の要点です。出典の無い精度や削減率は、実績としては扱いません。判断に必要な手順は本文にまとめています。
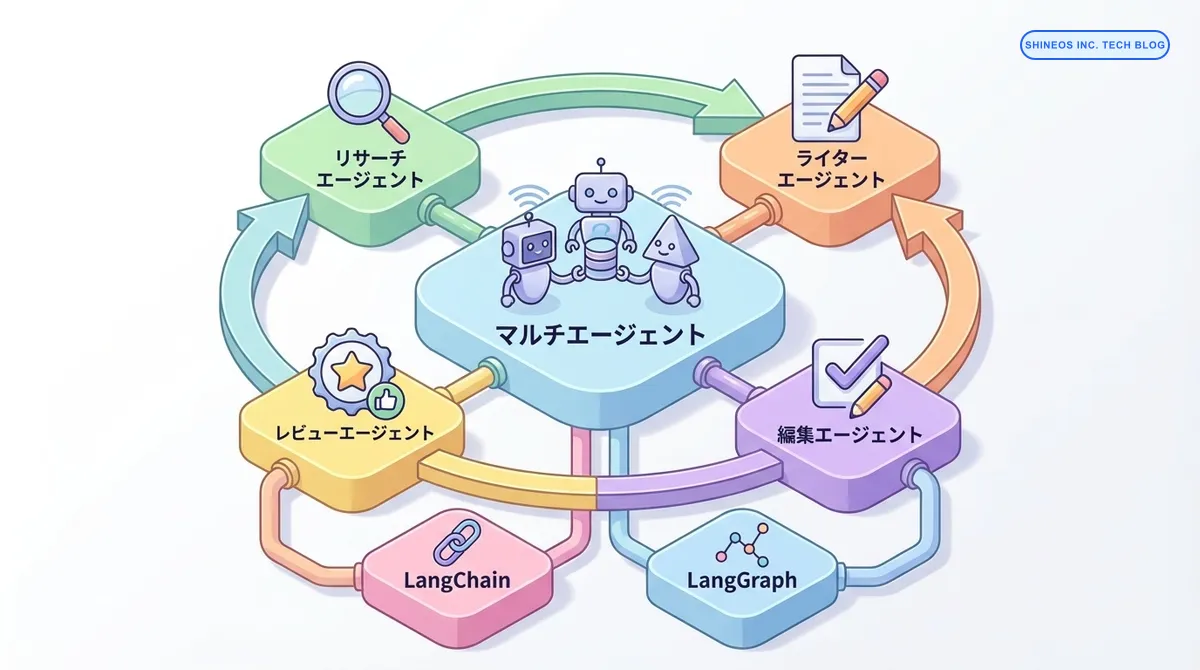
LangChainとLangGraphでエージェントの役割を分け、順次・並列・分岐で協調させる設計を解説します。役割を明確にしてからパターンを選ぶのが要点です。状態をグラフで持ち、担当外の情報は渡さない前提です。